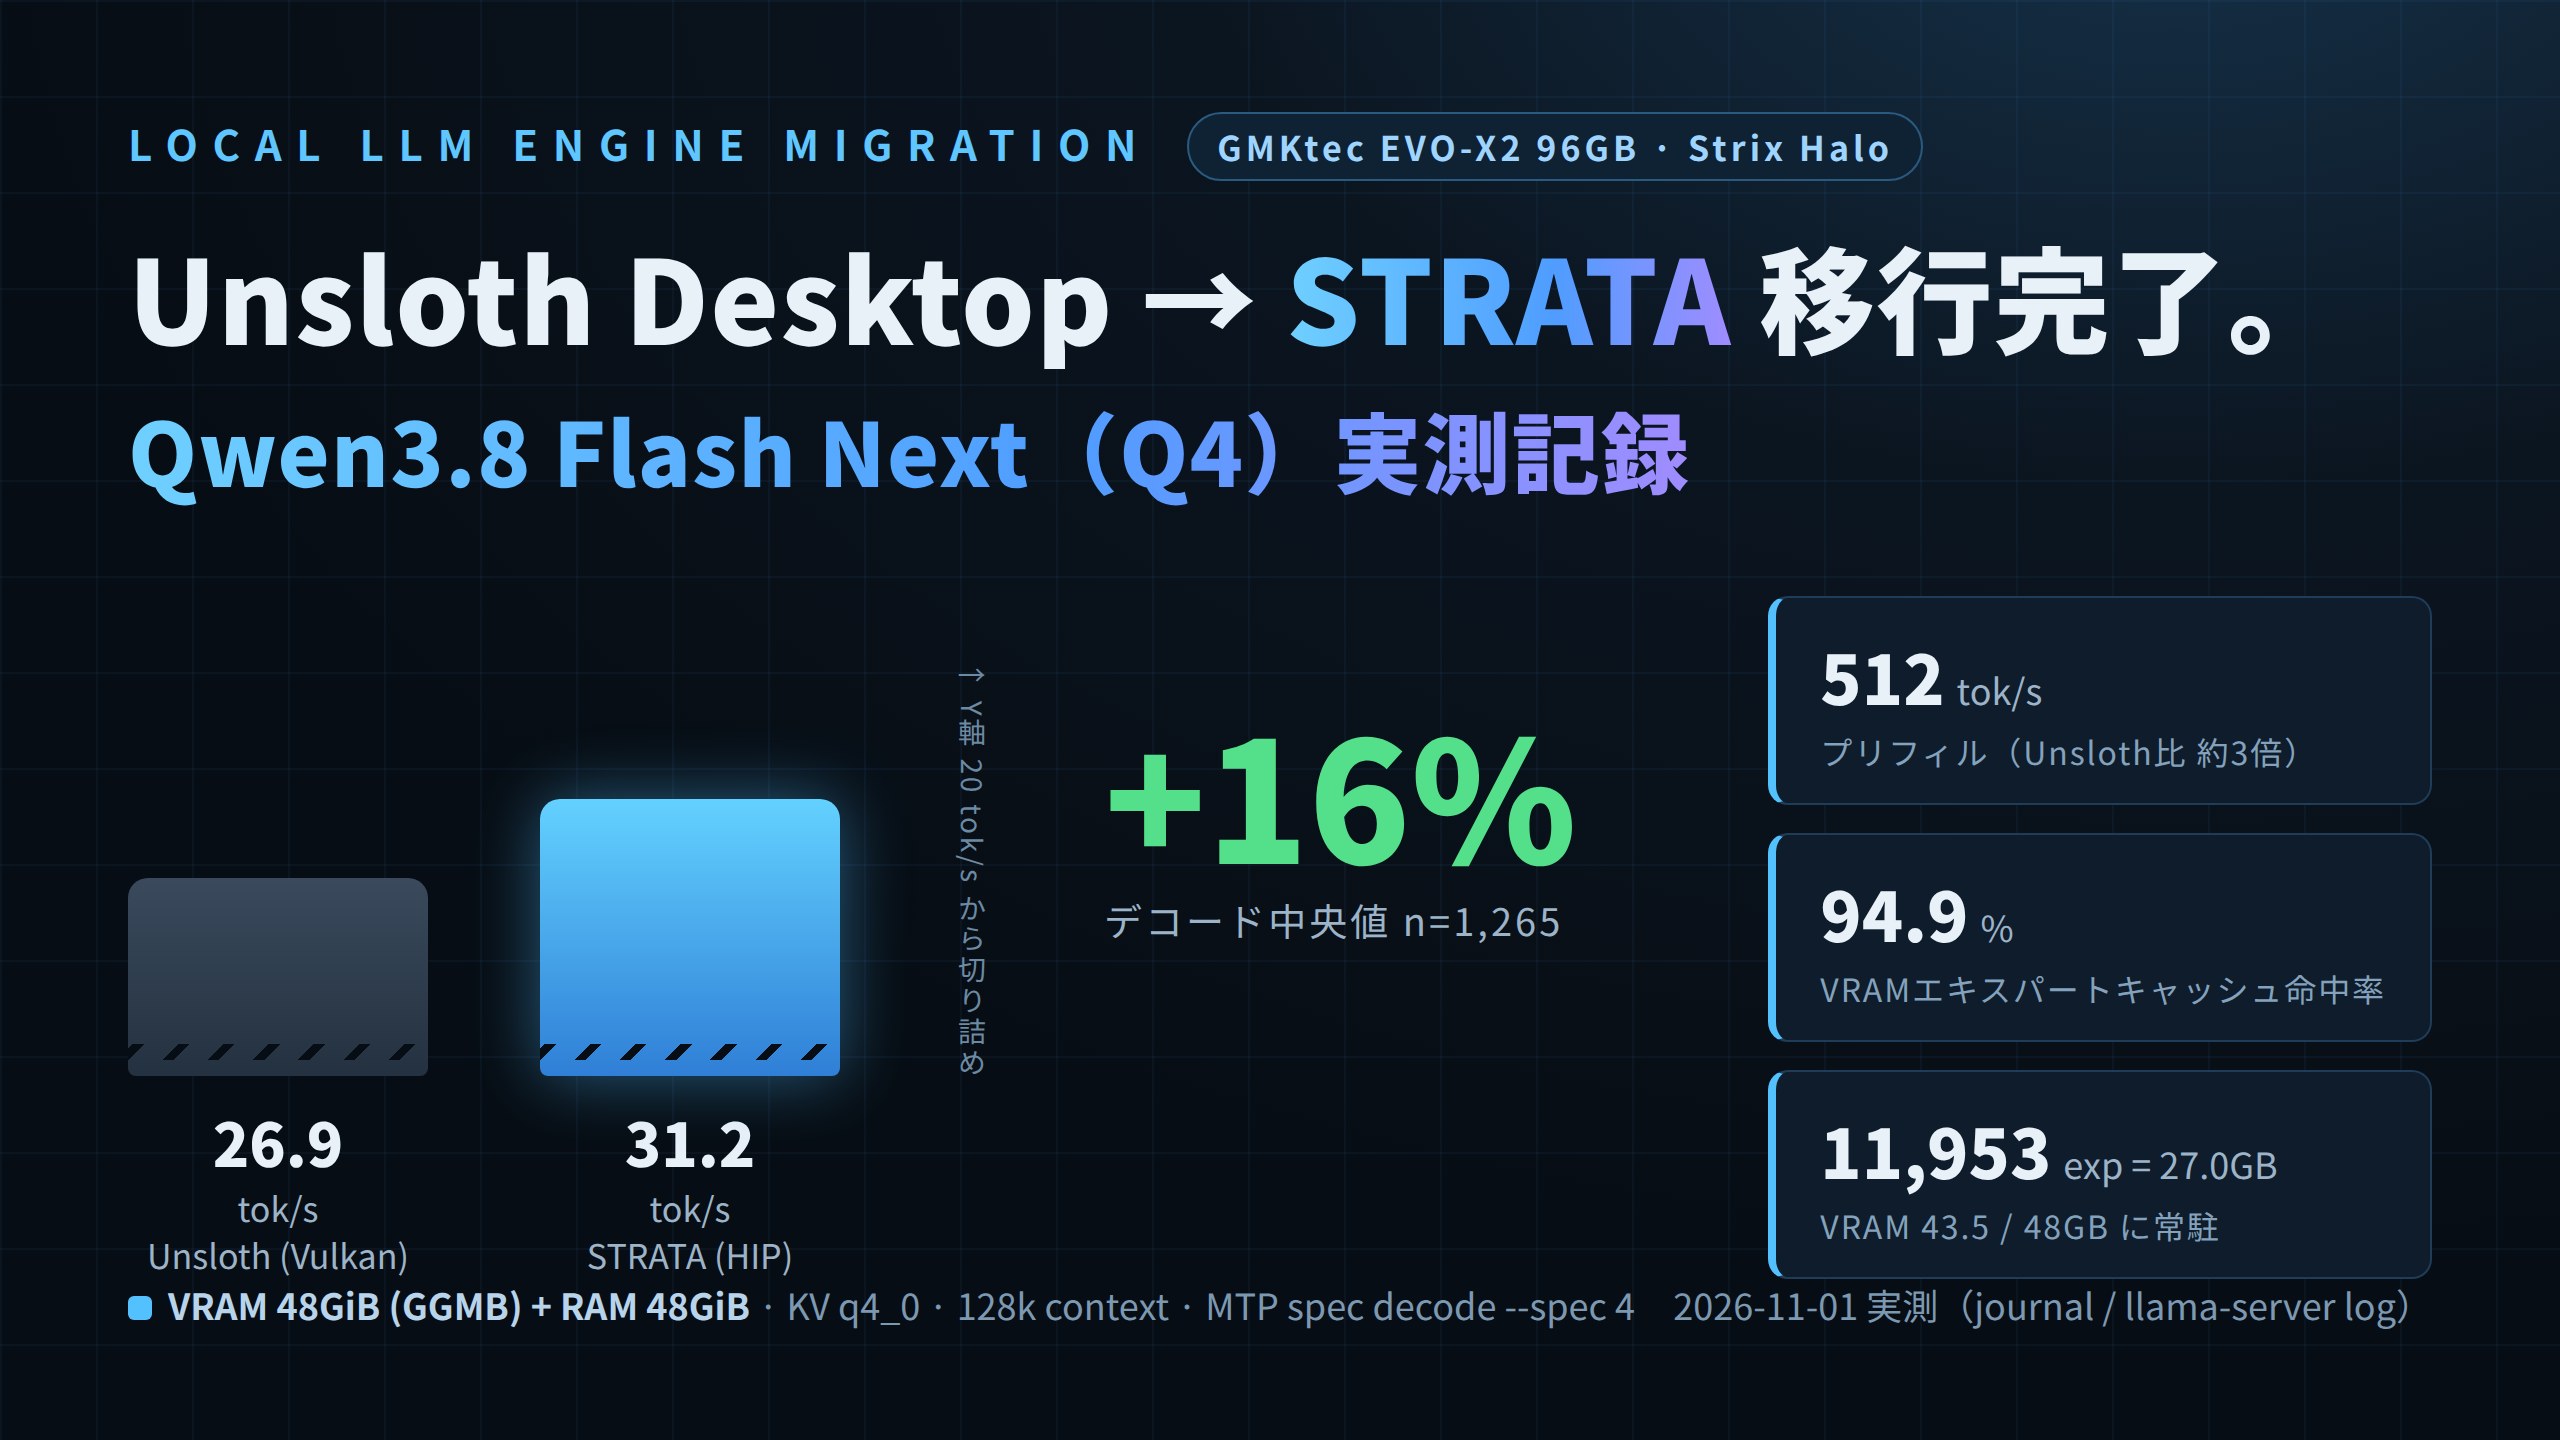
前に途中で止まっていた STRATA への移行を完了した。同じ基モデル(量子化ビルドは別)、同じ機械で、エンジンを差し替えて実運用データを取ったので記録する。
結論(先出し)
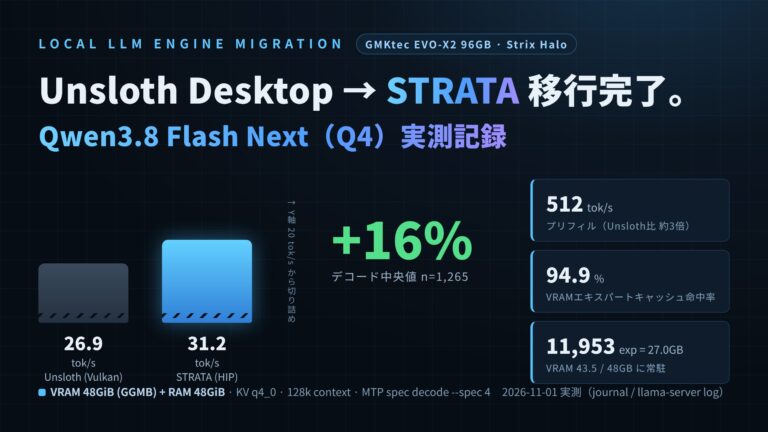
- デコード速度:中央値 26.9 → 31.2 tok/s(+16%)、平均 27.2 → 32.8 tok/s(+21%)
- 体感は「1割くらい速くなった」だったが、実測はそれを下回らず上回った。移行して正解。
- ただし主役は STRATA 単体ではなく VRAM(内显)48GiB を食いきる構成にできたこと。STRATA はそのための器として機能している。
環境
| 項目 | 値 |
|---|---|
| 機体 | GMKtec EVO-X2 (AMD Strix Halo, Ryzen AI Max+ 395 級) |
| メモリ | 96GB LPDDR5x。BIOS(GGMB)で VRAM 48GiB / OS RAM 約48GiB に切り分け |
| モデル(Unsloth) | Qwen3.8-Flash-Next PaoAI STRIX-BALANCED-2.1(PaoAI製 Strix最適化版。72.9 GiB) |
| モデル(STRATA) | Qwen3.8-Flash-Next UD-IQ4_XS(Unsloth Dynamic。87.2 GiB) |
| 構成 | 128k context / KV q4_0 / MTP 推測 (–spec 4) |
| 比較前 | Unsloth Studio 内蔵 llama-server(Vulkan 8060S + --spec-type draft_mtp) |
| 比較後 | STRATA 0.1.55(strata-engine-0.1.55-linux-x86_64-hip-halo、HIP バックエンド) |
STRATA 側の起動パラメータ(実運用):
strata --serve --pack packs/unsloth-ud-iq4_xs \
  --native models/UD-IQ4_XS/Qwen3.8-Flash-Next-UD-IQ4_XS-00001-of-00003.gguf \
  --spec 4 --spec-min-p 0.5 \
  --expert-profile data/expert-profile.bin --expert-cache auto \
  --prefill 2048 --max-context 131072 --kv q4_0 --resident-budget-gib 38
実測データ
量子化構成は GGUF ヘッダで検証済み(重要)
「同じ GGUF を積んでいる」は誤りだと分かったので、ファイルを検証して訂正した。GGUF 読解ライブラリでテンソルの量子化型を全数カウントした実測:
| Unsloth で運用していたビルド | STRATA で運用中のビルド | |
|---|---|---|
| ファイル | Qwen3.8-Flash-Next-PaoAI-STRIX-BALANCED-2.1.gguf |
Qwen3.8-Flash-Next-UD-IQ4_XS(3分割) |
| 総サイズ | 72.9 GiB | 87.2 GiB |
| 中身 | Q3_K_M 65.7%(47.9GB) + Q8_0 26.5%(19.3GB) + F32 5.7% + Q2_XS 微量 | MOSTLY_IQ4_XS(file_type=30) |
| 性格 | PaoAI が Strix Halo 向けに調整した軽量ミックス(重要層 Q8、专家 Q3_K) | Unsloth Dynamic の高ビット量子化 |
つまり STRATA の方が 約14GB 大きく、より高ビットの重みを積んでいる。サイズが大きいほど読み出しは不利なので、その不利を背負って STRATA が速い。エンジン差は表の数字以上にある可能性が高い。
デコード速度
Unsloth(llama-server ログ、10/28 18:56〜10/31 20:13、809 リクエスト)
| 日付 | n | 中央値 tok/s |
|---|---|---|
| 10/29 | 307 | 25.8 |
| 10/30 | 394 | 26.4 |
| 10/31 | 108 | 30.0 |
| 全期間 | 809 | 26.9(平均 27.2、四分位 23.4〜30.5) |
STRATA(systemd journal、11/1 当日、456 リクエスト・総生成 410,410 tokens)
| 指標 | 値 |
|---|---|
| 平均 | 32.8 tok/s |
| 中央値 | 31.2 tok/s |
| p90 | 43.5 tok/s |
→ 中央値 +16%、平均 +21%。「体感1割」は控えめすぎる報告で、実測はもっと良い。
プリフィル(プロンプト読み込み)
- Unsloth:
prompt eval time中央値 163 tok/s(平均 166.6、最大 345) - STRATA:進捗ログの間隔計測で 約512 tok/s(2048トークンチャンク刻み。プロンプトキャッシュ上位層が効くと見かけ 1,000+ tok/s になることも)
Hermes のように毎回数万トークンのプロンプトを積むエージェント運用では、ここが地味に一番きつい差。3〜5 倍の差がついている。
MoE エキスパートキャッシュ(STRATA の勝ち筋)
STRATA は MoE のアクティブエキスパートを VRAM に載せるキャッシュ機構を持つ(--expert-cache auto)。
- 11/1 当日:ヒット率 平均 93.7%(中央値 94.9%)。PCIe 越しに補充するのはルーティング済みエキスパートの 1.7〜2.6% だけ。
- VRAM を一時 32GiB に絞った時の対照実験:ヒット率 54%、デコード 13〜14 tok/s に半減。32GiB 復旧後 26〜27 tok/s へ即回復。
つまり Strix Halo の共有メモリ構成では「VRAM に何 GiB 載せられるか」が速度を決め、STRATA はその枠を自動配分してくれる。Unsloth 側にも MTP ドラフトはあるが、エキスパート配置の自動化は STRATA の方が一段上。
移行で詰まった点(前回の中断理由)
- MTP ドラフトヘッドの読み込み:STRATA は「ファイル末尾のテンソラ」を先頭から順に走査してドラフトヘッドを拾う。Unsloth 公開版はテンソラ名が
tken.*で、かつファイル末尾に置かれている必要があった(先頭側だと読み飛ばされる)。 - Vulkan ビルドは動かない:
rocm-smiに見えない GPU を STRATA が認識しない。-linux-x86_64-hipバックエンド一択。 - expert profile の自動取得:
--expert-profile autoは学習済みハッシュ辞書のダウンロードに失敗するため、端末同梱のexpert-profile.binを明示指定する必要がある。 - RAM 予算の警告は実態に合わせ上書き:
--resident-budget-gibを RAM 実量超過のままにしない(デフォルト値は無視して GGMB から再計算)。
リソース占有の実証(btop、同日 21:03)
エンジン稼働中のシステムスナップショット:
| 項目 | 値 |
|---|---|
| GPU | Radeon 8060S 100%、VRAM 44 / 48 GiB を使い切り |
| strata プロセス (pid 43063) | RSS 32 GiB(CPU側 RAM のエキスパート常駐分)、CPU 6.2% |
| パッケージ | 120W、CPU 82℃ / GPU 80℃、load avg 12.72 |
| システム RAM | 45.6 GiB 中 40.8 GiB 使用(89%)、swap 8.0 GiB 中 4.3 GiB |
VRAM 44/48 + RAM 32GiB が ENGINE 一つに食われている構図で、96GB 全量を推論に振り切れていることの裏付け。Swap 4.3GiB は常駐分ではなくデスクトップ側の追い出し(GTT 共有メモリの性質上、常時この程度は乗る)。
公平性のための注記(測り方の限界)
- 比較窓が異なる(Unsloth = 10/28〜31、STRATA = 11/1 当日)。バックグラウンド負荷の同一条件制御はできていない。
- 11/1 の STRATA データの一部は、本 Hermes セッション自身の稼働を含む(つまり私が速く動いている)。
- 重みは別ファイル。Unsloth 側は PaoAI 軽量ミックス(Q3_K_M+Q8_0、72.9GiB)、STRATA 側は UD-IQ4_XS(87.2GiB)。より大きく高ビットな方を積む STRATA が不利な条件での勝利で、厳密な同一 GGUF 比較ではない。エンジン差は表記以上にある可能性が高い。厳密に組むなら STRATA に PaoAI ビルドを食わせるか(要ヒープ80GiB設定)、Unsloth に UD-IQ4_XS を入れればよい。
- VRAM 48GiB・コンテキスト長 128k・KV q4_0・MTP 推測 ON という運用構成は同一。
このへんを割り引いても、中央値 +16% とプリフィル数倍は再現性十分な差と判断している。
今後のメモ
- 32GiB 下振れの実験が教えてくれたとおり、GGMB 48GiB 割当は「効きすぎ」でないと崩れる。常時 48GiB 固定でいく。
- 起動待ち 3 分弱は仕様。ready ファイルの mtime + 8080 疎通で判定する運用にしておいた。
- 速度の大小判定は n≥30 のリクエスト平均で。単発差(±30%)はノイズ。
著者について